Китайское издание ZhiDongXi сообщает: 20 октября ElevenLabs выпустила Eleven Realtime v1 Mini и Max; Max набрал 98,8% в речевом тесте. По данным Artificial Analysis, среднее время до первого звука у Max — 0,57 секунды. Для разработчиков это способ собирать голосовых агентов без ручного подбора распознавания речи, языковой модели и синтеза. На бумаге звучит удобно, но сама беседа ещё должна быть живой.
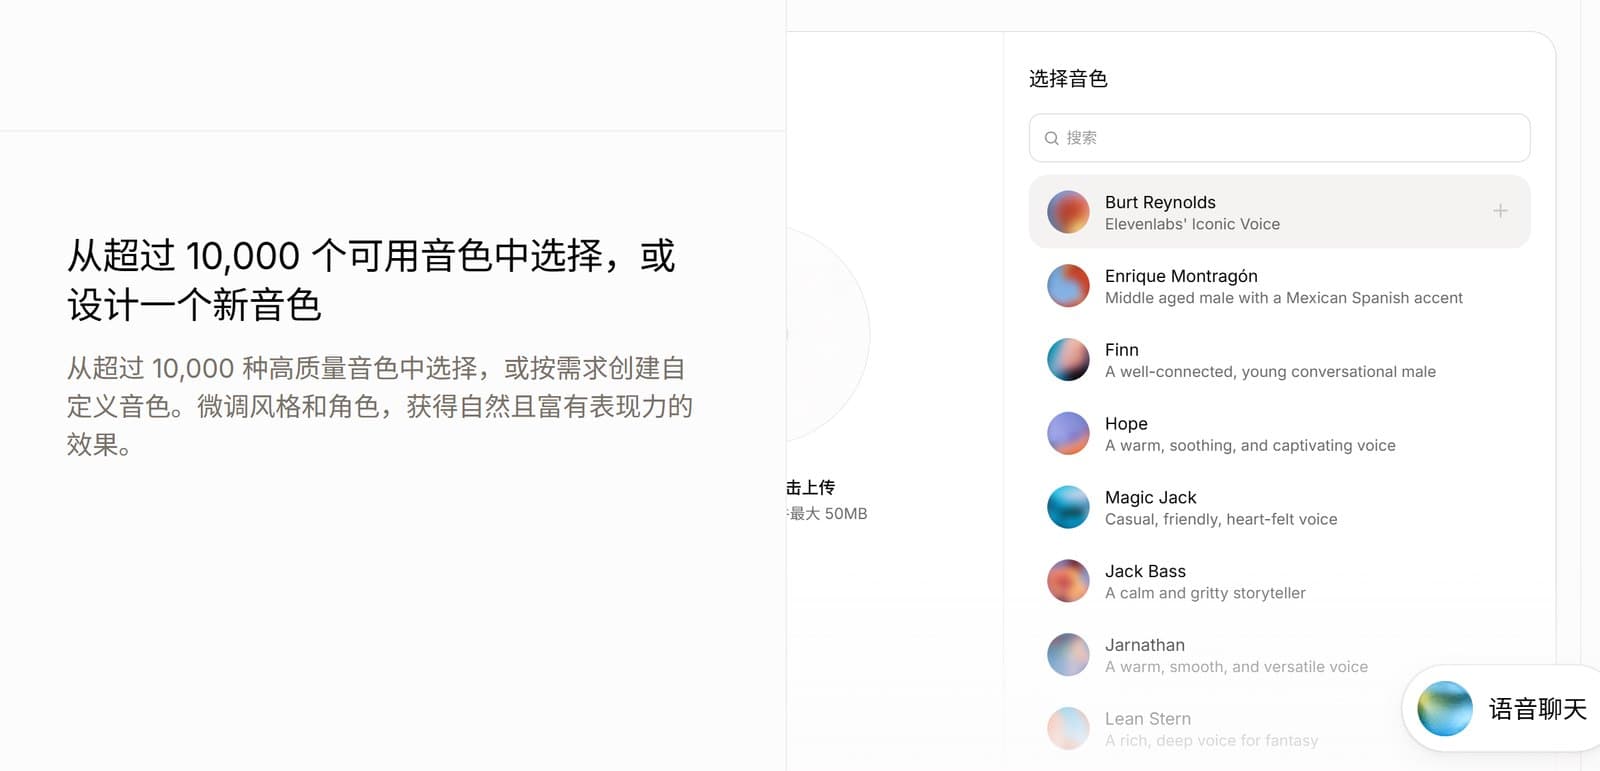
Модели понимают более 90 языков и работают с библиотекой из 17 тысяч голосов. Mini рассчитана на естественные разговоры, обучение и ролевые сценарии; Max — на поддержку клиентов и задачи с несколькими шагами и вызовом инструментов. В тесте Speech Agent Arena Max выполнял задачи с инструментами в 87,1% случаев, Mini — в 60,3%. Зато Mini немного лучше передавала очередь в разговоре: 95,8% против 94,1% у Max. Короче, выбор зависит от того, важнее ли вам выполнение команды или аккуратный диалог.
ZhiDongXi проверило голосового помощника Architect, который помогает настраивать агентов. Он смог по голосовой команде менять язык и другие параметры, без поиска нужных кнопок. Но китайская речь звучала с заметным иностранным акцентом, ответы были длинными, а перебить помощника удавалось не всегда. Были и задержки с подвисаниями. Важная оговорка: издание тестировало именно Architect, а не диалог с готовыми моделями — для запуска созданного агента нужны платные токены.
Mini и Max доступны через ElevenAgents и Realtime API; API совместим с OpenAI Realtime, но подключается пока только по WebSocket. После исчерпания лимита тарифа аудиосоединение стоит $0,08 за минуту. Токены тоже оплачиваются отдельно: у Mini — $0,20 за миллион входных и $6 за миллион выходных, у Max — $1,80 и $9 соответственно. Eleven Realtime использует связку распознавания, языковой модели и синтеза: её проще настраивать по частям, но скорость и естественность диалога всё ещё зависят от того, как сработает вся цепочка.
Источник智东西