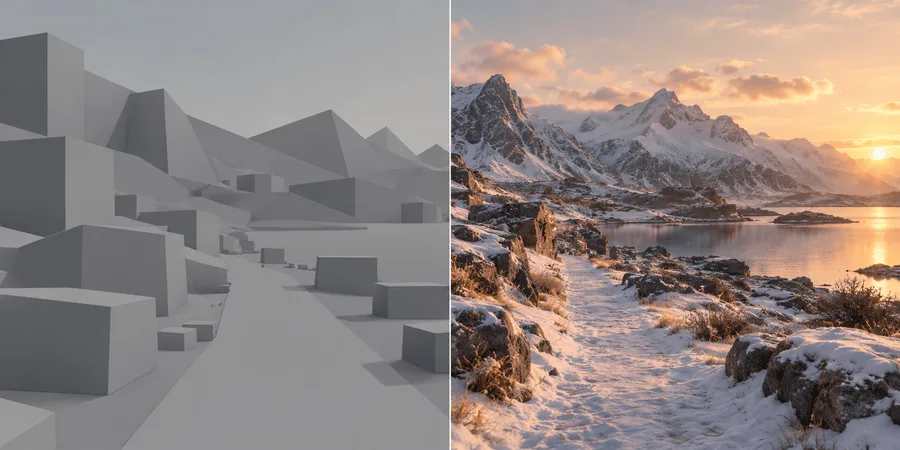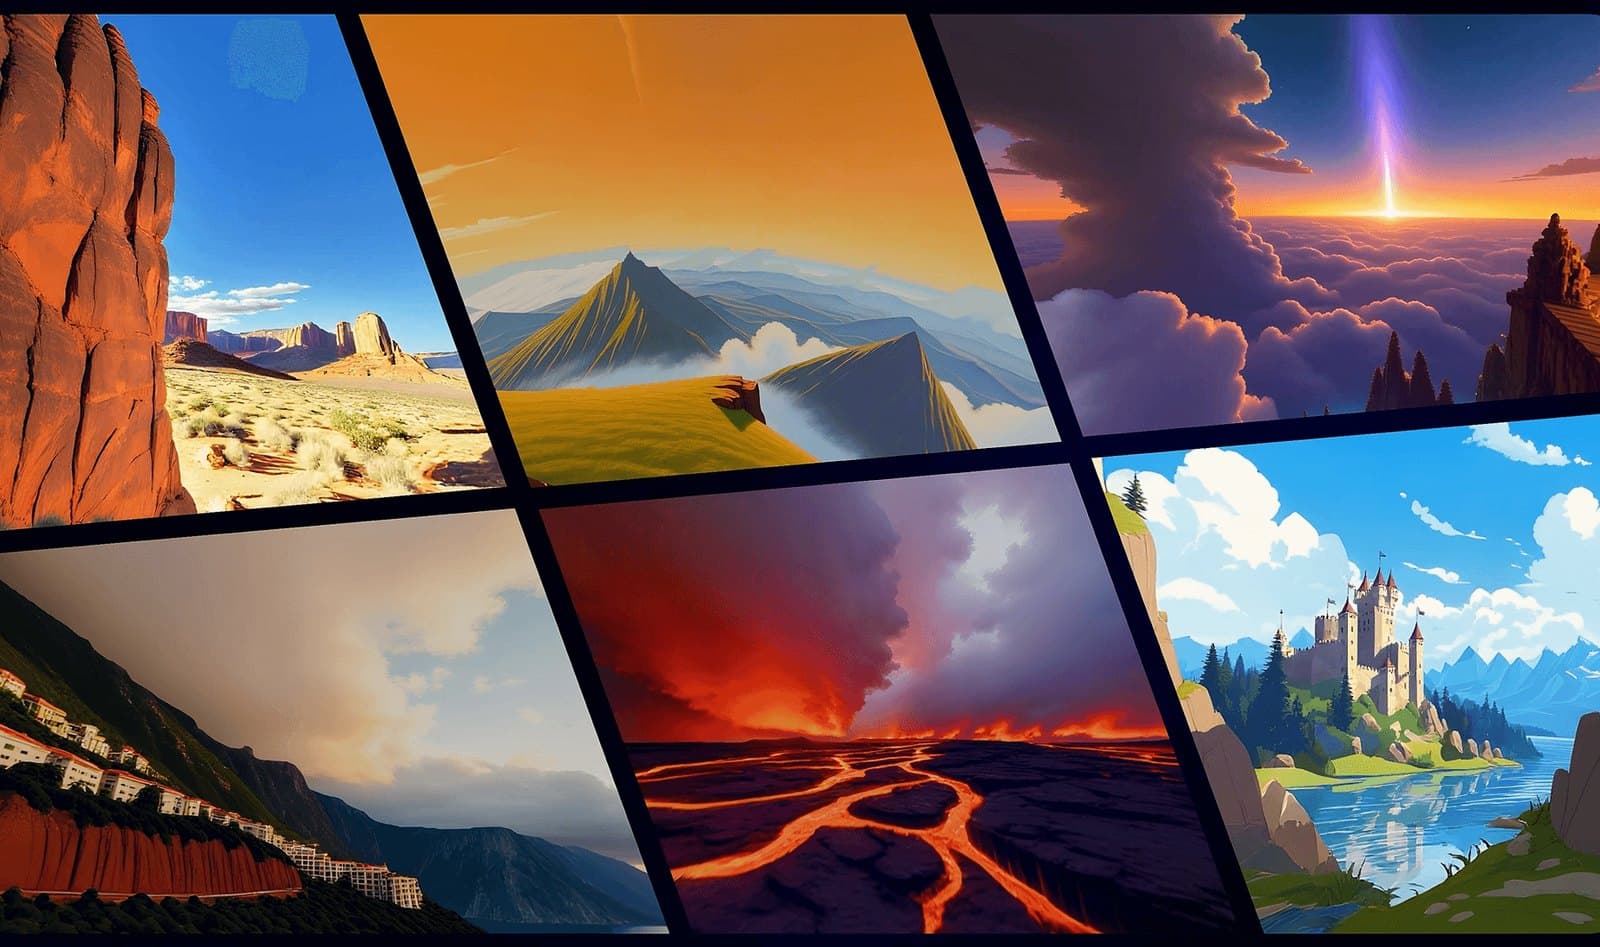
Tencent Hunyuan выложила Hy-Nomas на Hugging Face: модель генерирует видео сегментами в разрешении 720 × 1280 при 24 кадрах в секунду. Это не разовый клип по промпту: можно продолжать тот же мир, менять объекты, действия и стиль, а камеру вести отдельными командами. Для авторов это шанс удерживать сцену между продолжениями, а не каждый раз надеяться, что генерация вспомнит, где стоял предмет. Думаю, вот тут и главный интерес.
По карточке модели, новые сегменты учитывают предыдущую историю через KV-кэш. В дистиллированной конфигурации генерация использует 8 шагов денойзинга. Есть и отдельный вариант запуска на одной NVIDIA GeForce RTX 4090: с INT8-весами DiT и кэшем, FP8-декодером и переносом части вычислений на CPU. В веб-демо инструкции сначала преобразует отдельный сервис Nomas-PE; для офлайн-запуска можно использовать подготовленные файлы промптов.
Управление камерой задаётся вместе с текстом, так что можно менять не только содержимое мира, но и точку обзора. Вместе с моделью выпустили Hy-Nomas-Bench — набор из 280 тестов по четырём направлениям: диалоговое управление текстом, навигация камерой, их сочетание и пространственная память. Бенчмарк проверяет управляемость и последовательность при продолжении генерации, но сам по себе не говорит, насколько стабильно модель справится с любым вашим промптом. Зато идея понятная: не пересобирать сцену с нуля, а вести её дальше командами.
ИсточникHF: Tencent Hunyuan