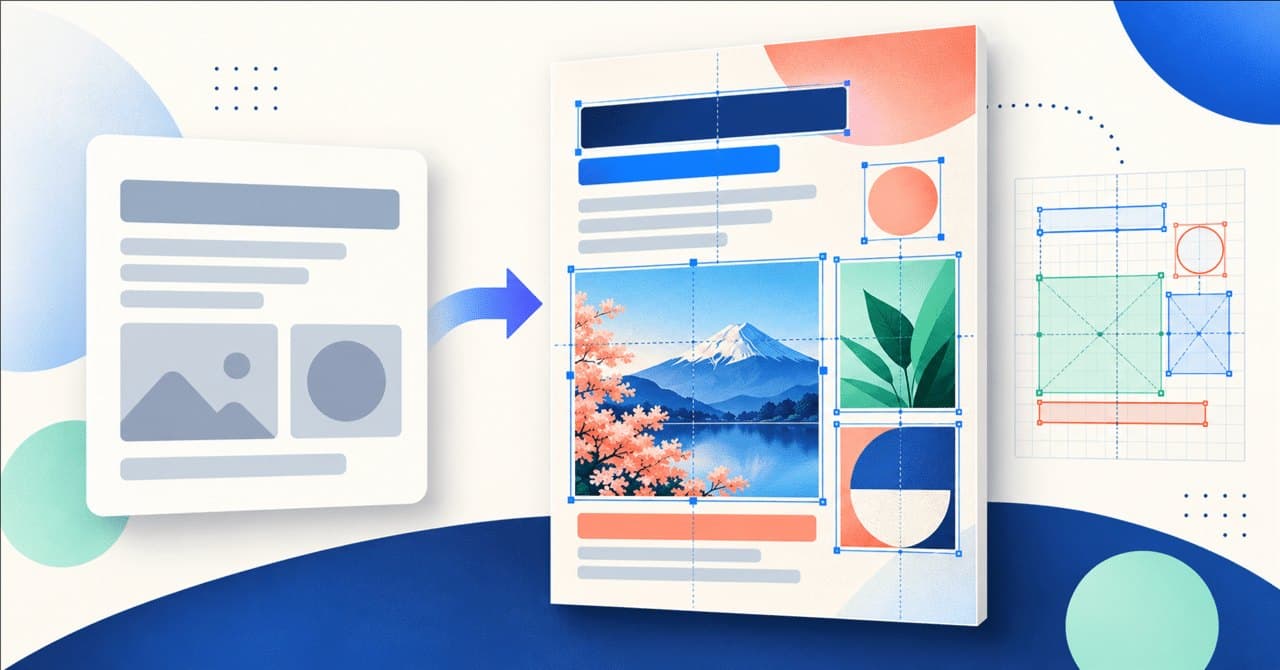
Команда MOSS-Image представила Base и SFT — модели, которым можно задавать текст и расположение элементов на изображении. Для постеров, схем и афиш это полезнее, чем просто просить нейросеть «сделать красиво»: можно указать, где будут заголовок, фото и описание.
В официальном репозитории для этого предлагают JSON-инструкции с элементами и их координатами — фактически рамками, внутри которых их нужно разместить. MOSS-Image рассчитана на изображения с несколькими объектами и длинным текстом на английском и китайском. В основе — модель на 5 млрд параметров. Разработчики показывают, что SFT-версия аккуратнее размещает группы текста, но это их пример, а не гарантия для любой генерации.
Есть важный подвох: сейчас MOSS-Image создаёт картинки с нуля, но не умеет взять загруженное изображение и поменять в нём фон или одежду. А сгенерированные надписи всё равно нужно проверять — особенно даты, адреса и цены. Для запуска потребуются Python и подходящее вычислительное окружение, так что это не кнопка «сделать баннер за секунду». Думаю, пока модель интереснее как способ собрать черновой макет, чем как готовый редактор изображений.
Источникnote #画像生成AI