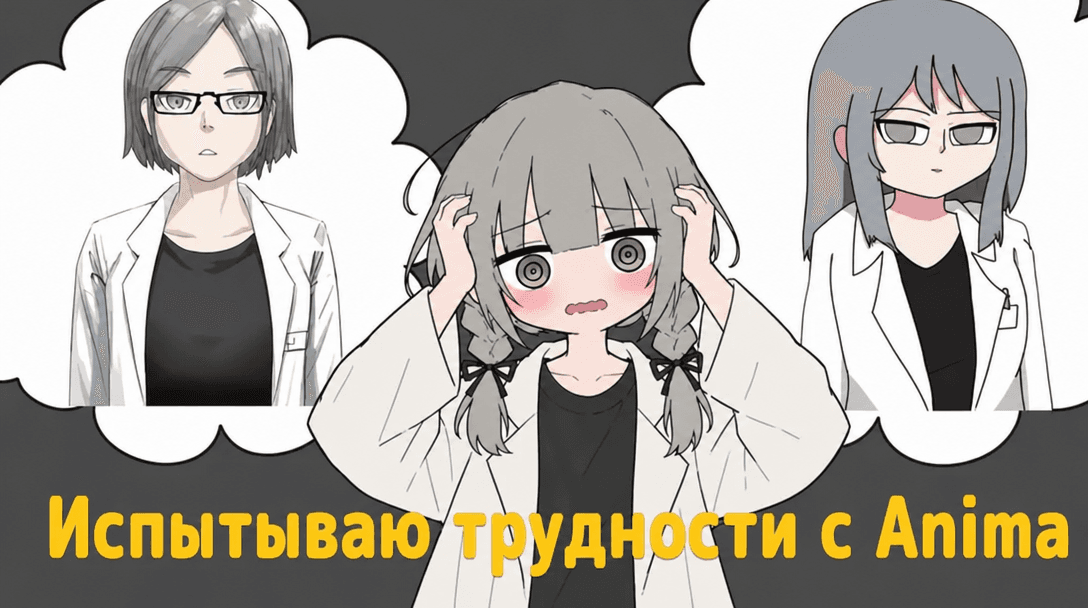
Японский автор гайда протестировал Anima Aesthetic v1.1: кадр 832×1216 занял около 26 секунд на RTX 5060 Ti. Он рисовал персонажа только промптом — без референса и LoRA, которая запоминает героиню. Для тех, кому важна узнаваемость персонажа, результат пока требует точных описаний и терпения.
По данным гайда на note, Anima — модель на 2 млрд параметров от CircleStone Labs и Comfy Org. Для запуска в ComfyUI нужны три файла: сама модель, текстовый энкодер Qwen и VAE; готовый шаблон уже есть, но вместо Base автор выбрал Aesthetic v1.1. На компьютере автора с RTX 5060 Ti 16 ГБ генерация на 30 шагах использовала около 6,9 ГБ видеопамяти.
Качество тегов вроде masterpiece и best quality почти не повлияло на сходство. А вот точные детали помогли: после указаний на причёску, сонный взгляд и одежду появились косы с чёрными лентами, белый халат и лоферы. Теги и обычный английский текст справлялись с глазами и одеждой примерно одинаково. Но фон в клетку сработал только в текстовом описании: вероятно, так модели яснее, к чему относится указание.
Подмешанные LoRA меняли рисунок и детализацию, но почти не трогали лицо и композицию; автору больше понравился вариант без них. Для сравнения с SD1.5 и Illustrious автор использовал старые изображения, так что это не равный тест. Illustrious показалась ему послушнее, а Anima точнее прорисовала мелкие детали одежды. Есть и быстрый режим: с Turbo LoRA и 8 шагами генерация заняла около 4 секунд, но все три изображения оказались с ракурсом сверху. Думаю, Anima интересна тем, что понимает и теги, и обычный текст, но точный характер персонажа одним промптом пока не удерживает.
Источникnote #画像生成AI