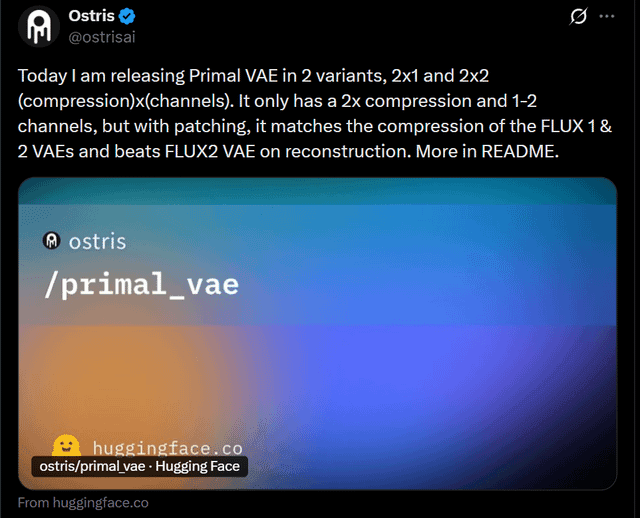
Ostris выпустил Primal VAE: он уменьшает пространственный размер латента в 2 раза и сводит его к одному каналу (или двум). Такую схему можно довести до привычного 8-кратного сжатия, передав патчинг модели DiT.
В описании на Reddit Ostris объясняет: после кодирования латент патчат с размером 4. На выходе получается 8-кратное пространственное сжатие и 16 каналов — как у многих современных VAE. При этом сам VAE остаётся компактным, а патчинг выполняет DiT, которая и так работает с патчами.
Ещё одна особенность — латент обучали сохранять норму на уровне шума. Поэтому, по словам Ostris, не нужны коэффициенты масштабирования и сдвига или отдельная нормализация латента: схема сводится к «закодировать, патчить 4, диффузить». Репозиторий Primal VAE указан на Hugging Face.
Заголовок поста на Reddit обещает результат лучше Flux.2 VAE, но в самом описании нет сравнительных тестов или цифр качества. Так что пока это интересная архитектурная заявка, а не подтверждённая победа над Flux.2.
ИсточникReddit: AI-видео и картинки