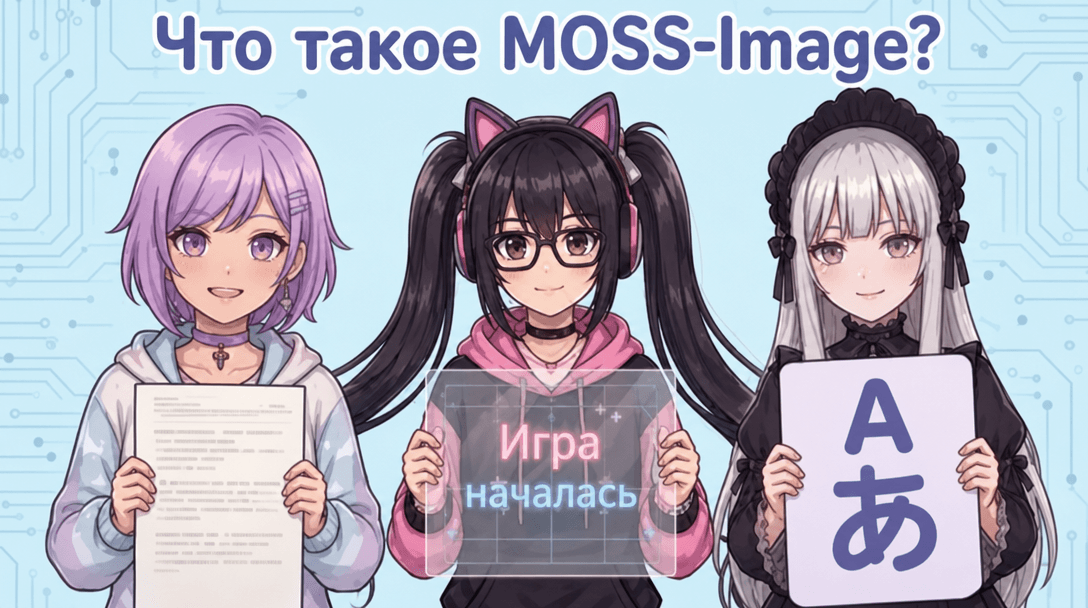
MOSS-Image от OpenMOSS показала среднее покрытие текста 96,3% в тесте длинных надписей. Для постеров, меню и упаковки это может означать меньше испорченных слов и ручной пересборки. Но цифра — от самой команды, независимой проверки пока нет.
Модель вышла 16 октября с открытыми весами под Apache 2.0: её можно скачивать, менять и использовать коммерчески. В тесте LLTB проверяли английский и китайский — по 120 заданий на язык, со средним объёмом около 1 340 символов. Команда сообщает о 97,1% покрытия для английского и 92,4% для китайского. Японский в этих замерах не проверяли, так что длинные надписи на нём лучше вычитывать вручную.
Фишка не только в тексте. В запросе можно задать элементы и их координаты через JSON: например, поместить заголовок в одну область, иллюстрацию — в другую. Для коротких пожеланий есть расширение промпта, которое само уточняет структуру и расположение, но оно использует внешнюю языковую модель. По внутреннему тесту команды на размещение элементов MOSS-Image тоже показала сильный результат; в слепом сравнении системы целиком она уступила GPT Image 2.
Это модель на 5 млрд параметров, а файлы занимают около 27 ГБ в bf16. Есть версии Base для дообучения и SFT для генерации — начать предлагают со второй. Модель доступна для запуска в ComfyUI, а с 20 октября есть Playground через API, но цену пока не объявили. Референсные изображения она не принимает и готовые картинки не редактирует, поэтому для плакатов с точной версткой звучит интересно, а как универсальная замена генератору — пока мимо.
Источникnote #画像生成AI