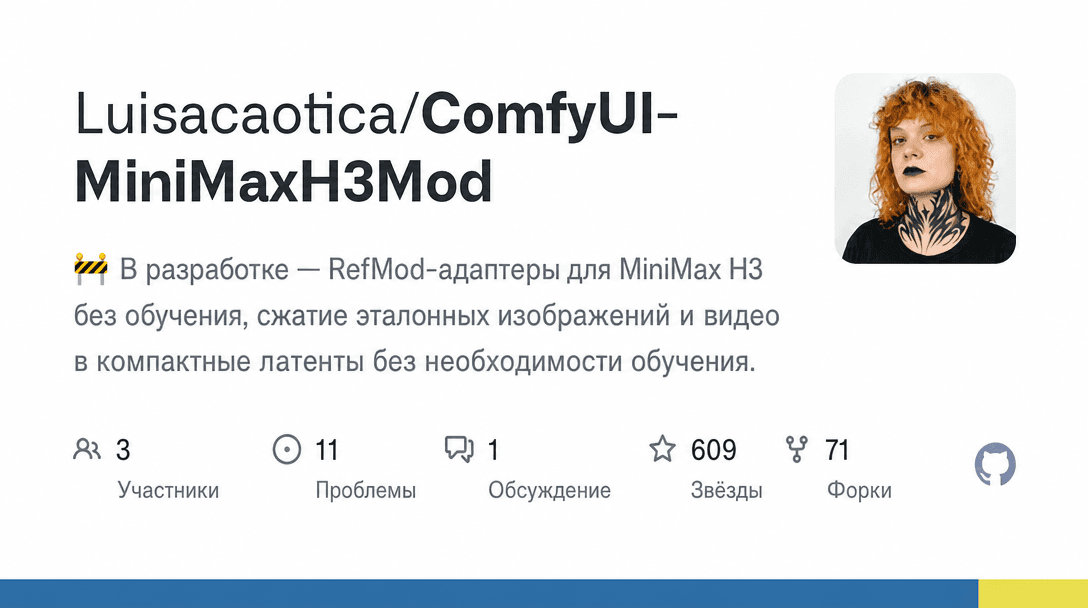
Пользователь Reddit u/EzkaProductions запустил RefMods для MiniMax H3 в ComfyUI на ноутбуке с 6 ГБ видеопамяти. Для тех, кто собирает серию клипов, это способ удержать одного персонажа и голос между генерациями — без обучения LoRA.
Как устроено: внешность персонажа извлекают из восьми изображений, голос — из короткого аудио. Получившиеся RefMods сохраняют как переиспользуемые файлы и подключают к новым генерациям. Автор пишет, что лицо, причёска и одежда остаются очень стабильными в разных сценах; голос тоже сохраняется от клипа к клипу.
Для настройки RefMods загружают в ComfyUI, а узел Apply H3 RefMod ставят между I2V-узлом и guider. Силу визуального и аудиореференса можно задавать отдельно: в примере автора оба значения — 0,9. Чтобы уложиться в 6 ГБ VRAM, он использует H3 SLA Attention, Low VRAM Attention, Chunk FeedForward и Turbo LoRA.
Для двух героев автор советует хранить каждого персонажа и его голос в отдельных файлах, а в промпте явно указывать имя, внешность и положение в кадре. Для workflow нужны ComfyUI-MiniMaxH3Mod, ComfyUI-PlagueKind-Nodes и KJNodes. Судя по описанию, это удобный способ закрепить референсы, хотя результат всё равно зависит от промпта и исходных образцов.
ИсточникReddit: AI-видео и картинки