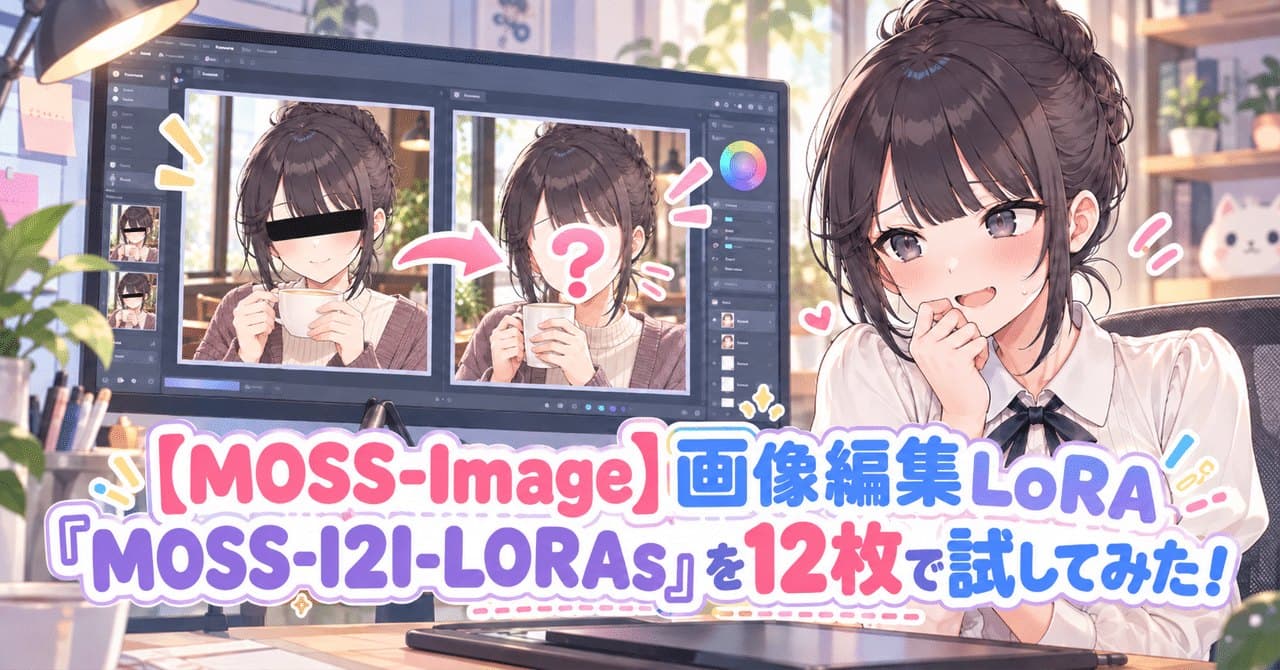
Японский автор гайда на note проверил MOSS-I2I-LORAs на 12 изображениях: LoRA раскрасила все три чёрно-белые иллюстрации. Для тех, кто редактирует картинки локально, это пока самая надёжная из четырёх проверенных задач: удаление текста сработало лишь частично, а мозаика и чёрные плашки остались.
Набор LoRA сделан для MOSS-Image-Base — модели, которая сама по себе генерирует изображения по тексту, но не редактирует готовые. Для раскраски, удаления надписей и снятия мозаики или цензурных плашек предусмотрены отдельные рабочие процессы ComfyUI. Результаты раскраски сохранили линии и расположение объектов; автору гайда удалось добавить цвет одежде, растениям и фону. Вот это уже можно брать в работу, хотя конкретные цвета модель, конечно, выбирает сама.
С удалением текста всё менее стабильно. Фиксированный промпт убрал часть надписей, но где-то оставил речевой пузырь и испорченные буквы, а где-то — полупрозрачный след. Свободно указать, какую именно фразу стереть, нельзя: workflow использует заданную для обучения формулировку. На мозаике и чёрной плашке LoRA decensor не восстановила закрытые области. «Деньги верните! (шутка)» — так автор прокомментировал неудачу с мозаикой.
В гайде использовали MOSS-Image-Base INT8 ConvRot и текстовый энкодер Qwen3.5 9B INT8 ConvRot. Входные изображения размером 1254×1254 ComfyUI уменьшал до 1024×1024; результаты не дорабатывали вручную. Есть и техническая оговорка: на момент проверки, 24 октября 2026 года, для части сборок требовалось применить ещё не влитый фикс из PR #11 из-за несовпадения форматов. Короче, раскраску уже стоит попробовать, а удаление текста и «расцензуривание» пока лучше считать экспериментом.
Источникnote #画像生成AI