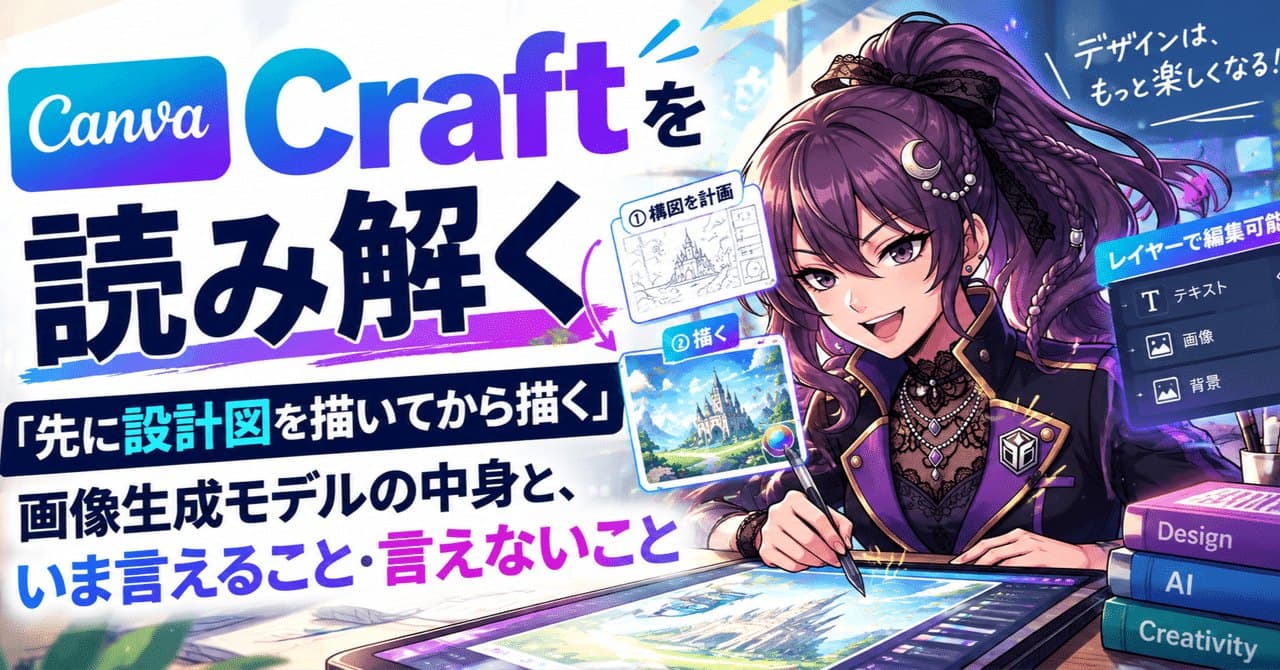
Canva 22 октября представила Canva Craft — свою первую модель генерации изображений, которая сначала планирует макет, а потом рисует. Для авторов афиш и постов это обещает не только картинку, но и более удобную основу для правок. По данным официального анонса, модель доступна всем пользователям Canva в Dream Lab; API для разработчиков пока работает в режиме превью.
Как пишет японский автор разбора на note, Craft делит работу на два этапа: сначала планировщик определяет расположение и размер объектов, визуальные акценты и текст, затем другая модель собирает изображение. Canva связывает такую схему с более точным текстом и композицией. Выход — до 2K, больше 30 форматов кадра, а текст внутри изображения заявлен на 55 языках. Как именно устроен планировщик, компания пока не раскрыла — тут остаётся ждать технических деталей.
Обучали Craft не только на фотографиях: Canva говорит о миллионах пользовательских шаблонов — постерах, презентациях, меню и публикациях для соцсетей. Это логично для модели, заточенной под дизайн. Но по скорости есть компромисс: в документации для разработчиков указаны примерно 50–60 секунд на генерацию. В сводке DesignArena среднее время — около 48,8 секунды против 18–27 секунд у двух лидирующих моделей OpenAI. В общем, быстро — не её главный козырь: в общем рейтинге DesignArena Craft заняла четвёртое место.
Ставка на правки раскрывается в паре с Magic Layers: инструмент Canva разбирает плоскую картинку на отдельные элементы и превращает надписи в редактируемые текстовые блоки. В тесте японского издания innovaTopia на листовке разбор занял около 20 секунд, но после замены шрифта текст местами съехал и потребовал ручной доводки. И Magic Layers работает не только с Craft, так что преимущество Canva скорее в связке генерации и редактирования внутри одного сервиса. Для макета, который всё равно надо допиливать, это может быть полезнее лишнего балла за красоту.
Источникnote #画像生成AI