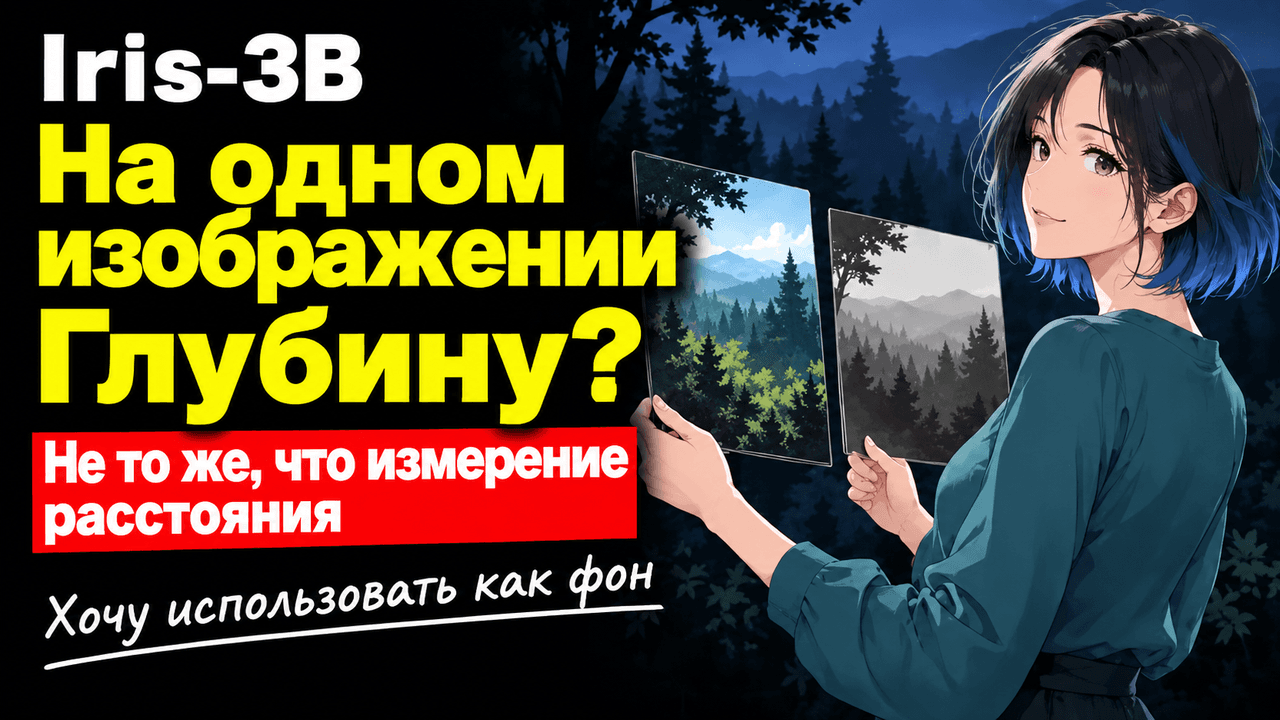
Японский креатор в заметке на note пишет: Iris-3B перед оценкой глубины уменьшает длинную сторону крупного изображения до 1024 пикселей. Для тех, кто хочет оживить статичный фон параллаксом, это полезная заготовка, но мелкие границы могут потеряться.
У модели есть отдельные веса для оценки глубины — генерация картинки сама по себе в этот режим не переключается. На выходе получается карта относительной логарифмической глубины: она показывает, что ближе, а что дальше, но не сообщает расстояние в метрах. Цвета на карте подстраиваются под каждое изображение, поэтому сравнивать по ним глубину разных картинок тоже нельзя.
Идея креатора — слегка сдвигать передний план и слабее двигать дальний, чтобы создать ощущение пространства в игровом фоне или на веб-странице. Это сценарий применения, а не готовая функция Iris-3B. И есть подвох: карта глубины не дорисует то, что скрыто за деревом или стеной. Думаю, начинать стоит с небольшого движения камеры и смотреть, не появляются ли дыры и растянутые края — особенно у веток, волос и оград.
В официальном коде крупные изображения сначала уменьшаются до длинной стороны максимум в 1024 пикселя, а результат возвращается к исходному размеру. Так что одинаковый размер файла на выходе не означает, что модель учла все мелкие детали. В статье от 7 октября прямое создание изображения из пикселей не показало явного преимущества перед сравнительной моделью с латентным представлением в задаче глубины; результаты зависели от датасета, а эксперименты были ограничены коротким обучением и одним запуском на условие. Автор заметки демо не запускал и качество, скорость и точность не измерял. Для запуска нужны CUDA-совместимая видеокарта и около 12 ГБ для весов глубины. Короче, это карта для лёгкого параллакса, не готовая трёхмерная сцена.
Источникnote #画像生成AI