Google Research 29 сентября показала Diffusion Controller, способ править ход генерации картинок без переписывания самой модели. Классическая история: просишь ящерицу в солнечных очках, а очки то пропадают, то лицо плывёт, если пытаться выбить их жёстче. Источник — блог Google Research и страница статьи на ICML 2026.
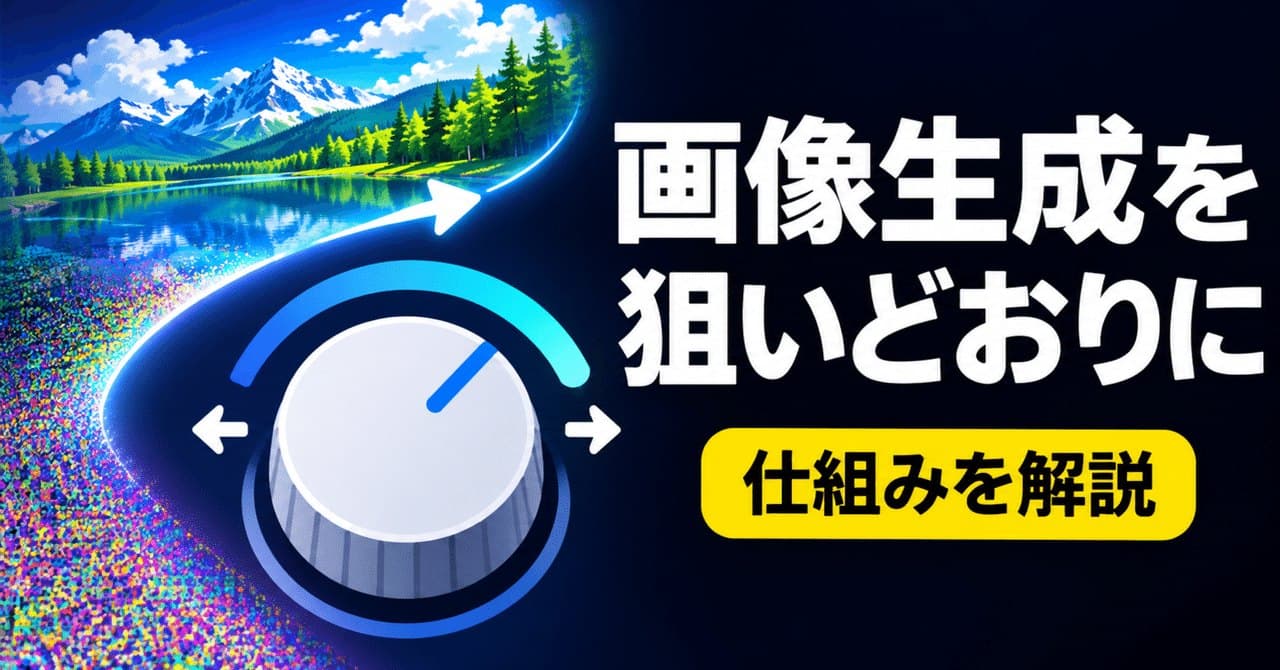
Генерация идёт в несколько шагов, и на каждом направление немного меняется. Diffusion Controller смотрит на этот процесс как на управляемый: базовая модель заморожена, рядом ставится небольшая управляющая сеть, которая видит промежуточное состояние и добавляет поправку. Google сравнивает это со стабилизатором руля на мотоцикле: мотоцикл тот же, но едет ровнее. Отдельно отмечено, что подход работает и тогда, когда доступ к внутренностям модели ограничен, то есть для закрытых сервисов.
Обучить такую сеть можно двумя путями. Если есть правильные пары «запрос — картинка», используется обычное дообучение SFT. Если есть только оценка результата, берут функцию потерь, взвешенную по качеству, или PPO. В тесте на Stable Diffusion v1.4 по оценкам HPS-v2 и людей вариант без полного доступа к модели обошёл LoRA в режимах SFT и взвешенной функции потерь. Важно: это результаты конкретных условий, а не доказательство превосходства во всём.
На практике есть один параметр силы управления: им регулируется, насколько жёстко модель держится за промпт. Google в планах называет персонализацию, защиту и видео. Но это исследование, а не готовый сервис, и в источнике нет данных о встраивании в продукты компании. Автор заметки делает вывод, который стоит запомнить: AI готовит варианты и сверяет их с запросом, а решает, что показать и что не публиковать, человек. Хороший руль не заменяет водителя.
Источникnote #画像生成AI