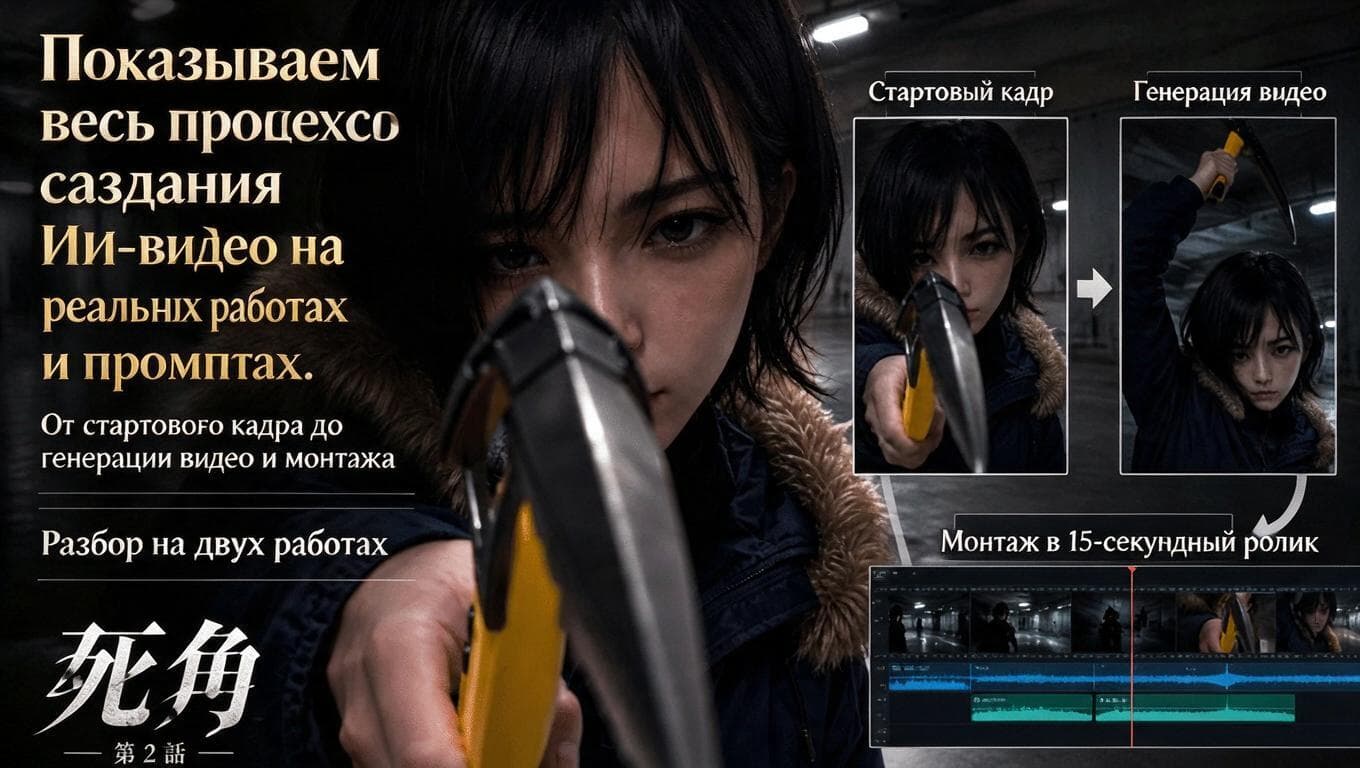
Жёлтый ледоруб почти касается объектива, а его хозяйка остаётся на заднем плане. Такой кадр автор японского гайда сначала собрал как изображение — чтобы при генерации видео не уехали ни перспектива, ни расстояние до камеры. Для тех, кому нужен конкретный план, а не лотерея с композицией, это прям полезное разделение работы.
На примере короткометражки «死角 第2話» автор публикует исходные изображения, готовое видео и использованные промпты. В подробном запросе для стартового кадра он фиксирует вид от первого лица, подземную парковку, положение лица и камеры, а также просит вынести острый конец жёлтого ледоруба к центру кадра, прямо перед объективом. Повторять ограничения разными словами не обязательно: сам автор оговаривает, что не проверял их сравнительным экспериментом. Суть — описывать расположение объектов так, чтобы его можно было увидеть на картинке.
Дальше в Image-to-Video остаётся задать изменение: Мина поднимает ледоруб над головой, но не двигается и не приближается. Ещё в исходном промпте были запреты на речь и музыку. Это пример принципа «один кадр — одно действие»: если персонажу нужно отойти, вернуться и замахнуться, автор предлагает разбить сцену на отдельные генерации и склеить при монтаже.
Есть и оговорка по лицу. Раньше автор отдельно просил сохранить бесстрастное выражение, но такие указания иногда вызывали лишнюю мимику или взгляд в камеру. Теперь он может вообще не описывать выражение, если оно уже задано стартовым изображением. Более короткий промпт в статье — только нынешний вариант для пробы, а не успешно проверенная пересборка сцены. Думаю, главный вывод тут простой: кадром задаём, что должно остаться, генерацией — что должно измениться. А целый ролик всё равно собирает монтаж.
Источникnote #動画生成AI