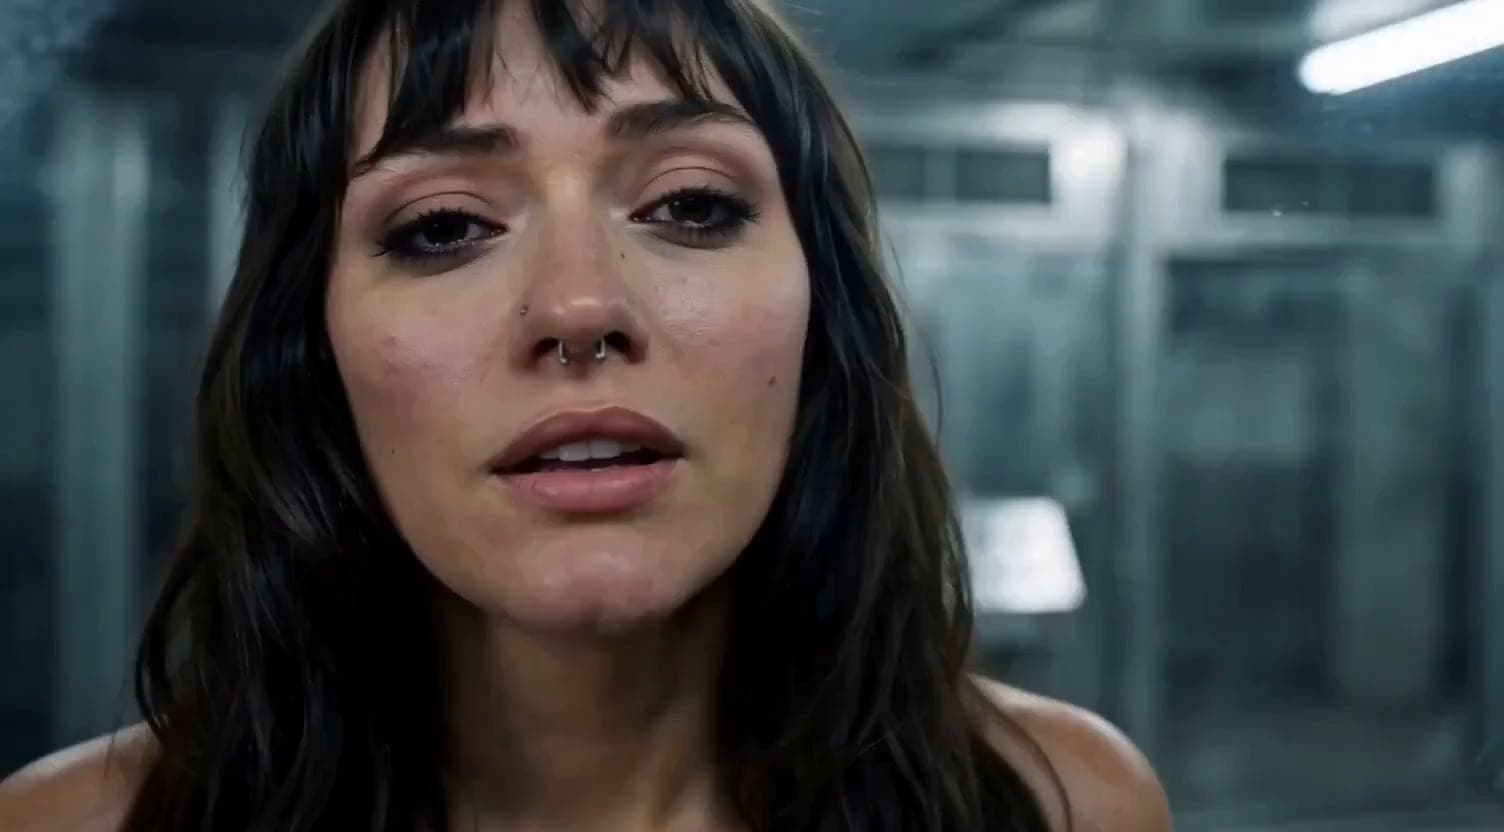
Персонажи в ИИ-видео часто говорят как роботы, а их лица выглядят слишком гладкими. Автор Reddit нашёл обходной путь для MiniMax-H3: не зажимать модель точным текстом. Пусть герой произносит бессмыслицу — так у него больше свободы в интонации, выражении лица и паузах. Потом звук и видео можно отредактировать, заменив речь на понятную.
Для теста автор взял один из сгенерированных клипов как референс, уменьшил его до 25% размера и применил размытие со значением 2. Это дало модели больше свободы и убрало излишнюю резкость. Картинку-референс тоже можно добавить, но в этом случае она ухудшила игру персонажа. Чтобы создать ощущение, будто сцены сняты в разное время, автор менял одежду, причёску и окружение героя, сохраняя исходный клип как референс. Другие варианты — снизить denoise или усилить размытие; голосовой референс можно задавать отдельно.
В промпте достаточно указать диалог. Автор иногда использовал официальный формат, чтобы снизить шанс новой порции бессмыслицы, но обязательным это не считает; подробно описывать единственного персонажа тоже не нужно. Исходный ролик создали в разрешении 544×384 и длительностью 12 секунд — автору такой хронометраж чаще давал удачный случайный результат, чем 10 или 15 секунд. После монтажа в Vegas Pro видео отрендерили в 256×180, а затем увеличили до 1920×1350 в HandBrake. Качество намеренно оставили lo-fi: автору нравится аналогово-цифровая эстетика, и, думаю, для неё такой подход прям к месту.
Главное
- Бессвязная речь здесь не баг, а способ получить более свободную и выразительную актёрскую игру.
- Картинка-референс может ухудшить мимику; автор обошёлся без неё.
- В ролике менялись детали внешности и окружение, хотя референсом оставался один исходный клип.
- Автор предпочитает 12 секунд: в его тестах этот хронометраж чаще давал удачный результат, чем 10 и 15 секунд.
ИсточникReddit: AI-видео и картинки