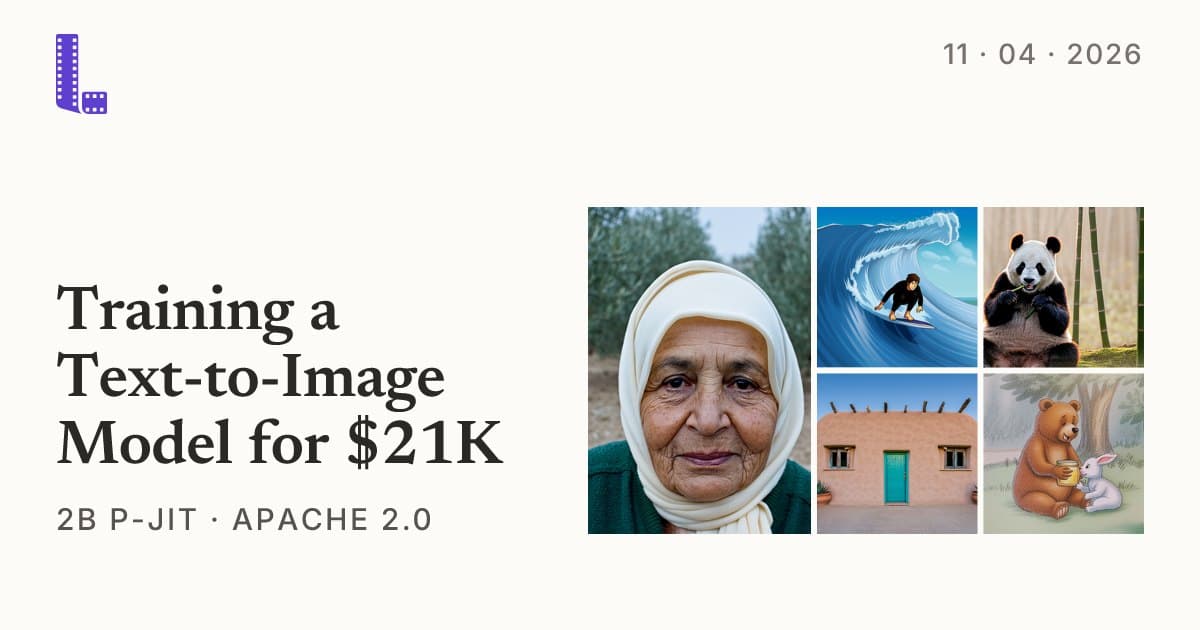
Двухчеловечная команда Linum выпустила открытую модель генерации картинок P-JiT и обучила её примерно за 21 000 долларов, около 28,5 млн вон. Об этом по данным GIGAZINE, которую пересказал Digital Today, 9 числа по местному времени. Для тех, кто гоняет генерацию на своём железе, важно другое: такое дешёвое обучение значит, что подобных моделей будет появляться больше.
Главная фишка в том, что P-JiT работает прямо с пикселями. Обычно картинку сначала сжимают VAE-кодировщиком в латентное пространство и потом восстанавливают. Здесь этого шага нет.
Что реально нового: токены стали крупнее. У прошлой модели Linum v2 было 16×16, у P-JiT 32×32. Тот же кадр 512×512 укладывается в вчетверо меньший контекст, и это главная причина, почему обучение обошлось так дёшево. По словам авторов, на обучение ушло примерно в 11 раз меньше семплов, чем у предыдущей модели. Текст обрабатывает замороженный Qwen3.5-4B, дальше идут 22 одинаковых блока диффузионного трансформера в одном потоке. Ещё добавили механизм readout: в начале сети он предсказывает картинку в низком разрешении и ускоряет сходимость. Обучение шло в два этапа: около 660 млн семплов на 512×512 и около 50 млн на 1024×1024.
Где подвох: текста на картинке не будет. В обучающих данных не было инфографики, PDF и книжных страниц, поэтому постеры и любые надписи модель не тянет. Авторы также признают, что для модели такого размера сложны полный рост персонажа, много объектов в кадре и взаимодействие нескольких людей.
Вывод: P-JiT показывает, что генерацию можно сделать дешевле, но заменой большим моделям она пока не станет. Если нужны постеры или текст, ищите другой инструмент. Следить стоит за доработками после открытия весов.
Источник디지털투데이 AI
Подробный разборМодель P-JiT работает прямо в пикселях — обучили за около $21 038 на вычисления