Reddit-пользователь pavel_0869874 выложил набор из 7 control LoRA для MOSS-Image-SFT: поза, глубина, канни, лайнарт, нормали, скетч и сегментация. Вы даёте модели позу, карту глубины или контурный рисунок, а промпт решает, кто на картинке и каким выглядит мир. Если нужно удержать позу персонажа или композицию кадра, это как раз та задача, под которую собраны эти LoRA.
Каждый тип контроля отвечает за свой вход. Pose берёт скелет позы, depth использует карту глубины, canny опирается на контуры, полученные фильтром Canny. Lineart работает с линейным рисунком, normal с картой нормалей, scribble с грубым наброском руками, а segmentation с разметкой областей. Выбор зависит от того, что у вас уже есть: готовая поза из референса, фото с глубиной или быстрый скетч.
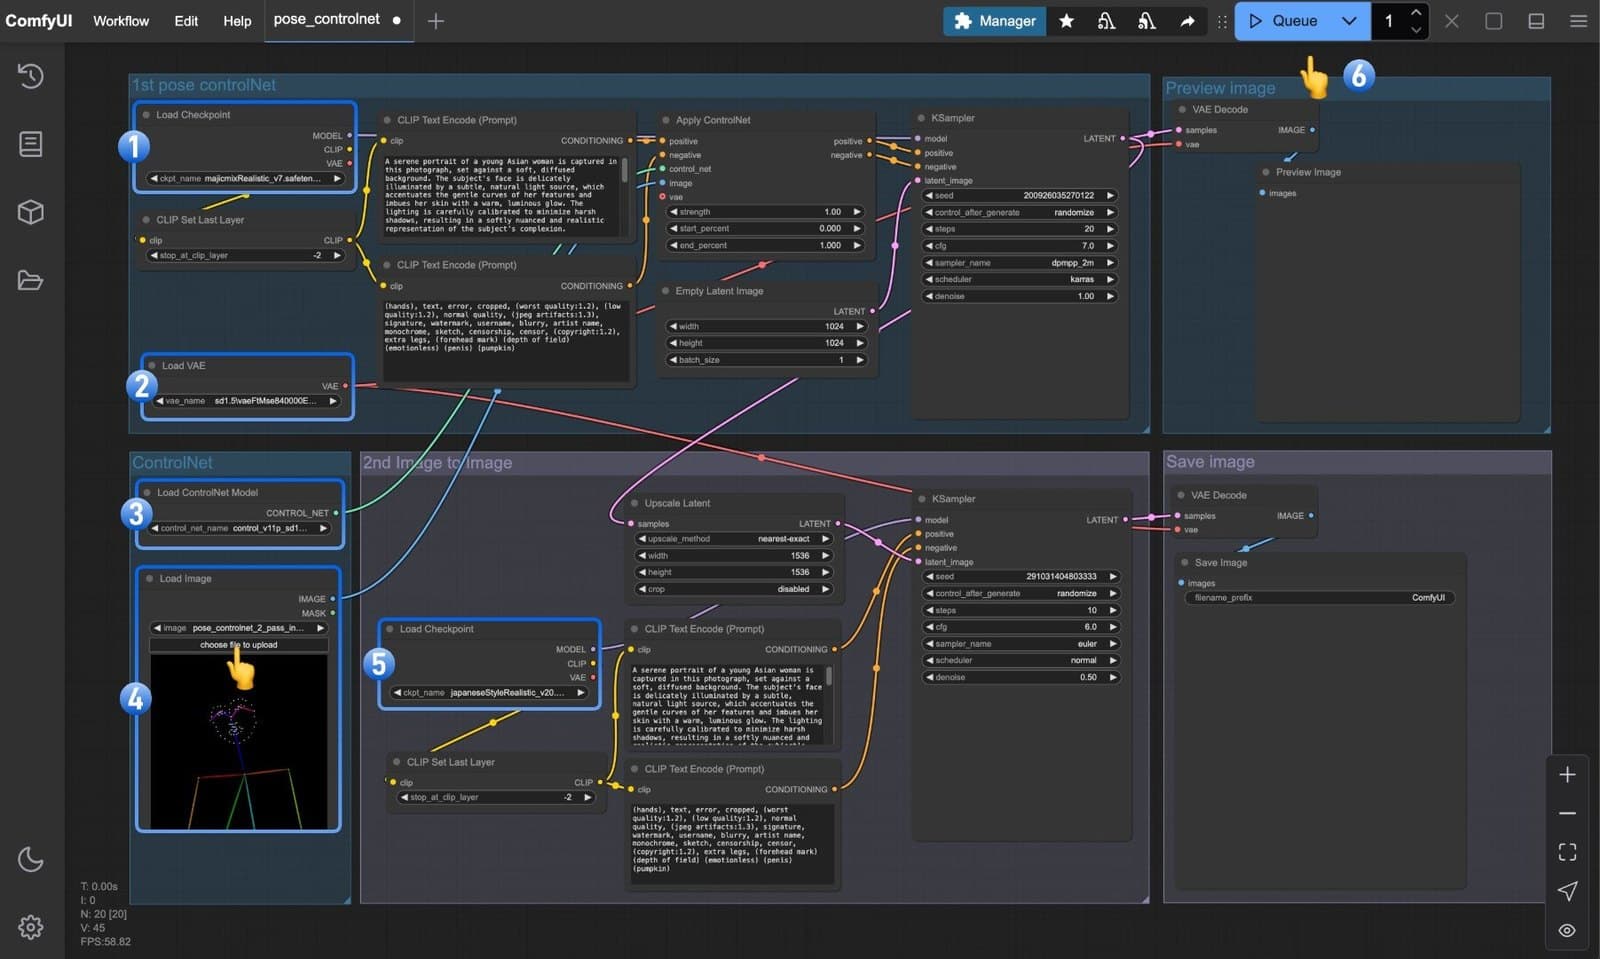
На Hugging Face у каждого типа свой репозиторий, и в нём лежат сразу два файла: сама LoRA и workflow для ComfyUI. Значит, порог входа невысокий: подключить нужную LoRA в граф, подать на вход свою карту или рисунок, описать сцену в промпте и смотреть, что выйдет. Отдельный пайплайн или обучение под свою задачу для этого не требуется, но и без проверки на своих картинках не обойтись.
Важная оговорка: в посте нет ни примеров результата, ни замеров качества, только ссылки и описание. По нему не понять, насколько точно модель держит заданную структуру, не ломает ли промпт и как ведёт себя на сложных позах. Это заявка от автора набора, а не проверка, так что сначала стоит прогнать свой референс.
Если вам нужна именно поза, начинать стоит с pose. Остальные пять-шесть вариантов удобнее держать в запасе под конкретную задачу.
ИсточникReddit: AI-видео и картинки