Японский автор на note замерил: MOSS-Image SFT на 12 шагах делает картинку за 18,8 секунды против 35,4, то есть на 47% быстрее. Для тех, кто гоняет сотни вариантов в поисках удачного кадра, разница заметна: сотня черновиков на 25 шагах занимает около 59 минут, на 12 шагах примерно 31.
Ставка простая: сколько картинок вы успеваете отсмотреть за час и какой ценой. Автор гонял все тесты на одной машине (RTX 5060 Ti 16 ГБ, ComfyUI, сэмплер er_sde, cfg 2.5, разрешение 1024x1536), с одинаковыми сидами и промптом. Менял только число шагов: 25, 16 и 12. Время брал из ComfyUI, без очереди и загрузки.
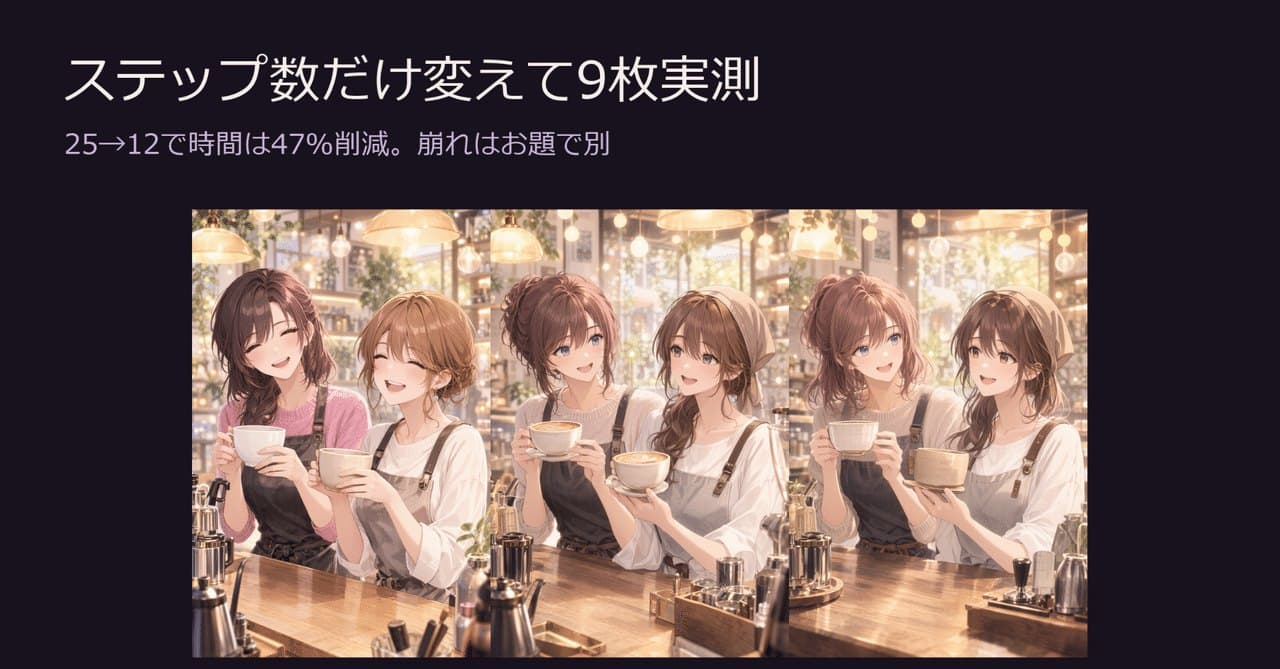
Главный сюрприз в том, что порог качества зависит от задачи. С японской надписью «もぐさ堂» на белой ткани-норэн на 12 шагах буквы поплыли, лицо и шея у женщины поехали, меню на доске стало нечитаемым. Ночной неоновый портрет при 12 шагах почти не изменился: кожа чуть глаже, и всё. Аниме с двумя персонажами терпит 12 шагов, но линии размыты, а пальцы с чашкой сливаются. Автор считает, что для текста нужно минимум 16 шагов, а для аниме 16 тоже безопаснее.
Схема из теста такая. Поиск кадра и черновики: 12 шагов и низкое разрешение. Короткий список кандидатов: 16 шагов. Финальные кадры, надписи и руки: 25 шагов. Сравнивать можно только при одинаковых промпте, сиде, cfg и сэмплере, иначе цифры ничего не значат. Автор не оценивал красоту, он смотрел только на наличие искажений: есть или нет.
Оговорка: цифры относятся к одной видеокарте и одной модели, это не закон. Время растёт почти линейно с числом шагов, поэтому 47% ожидаемы, а граница качества у каждого своя. Ни LoRA, ни дистиллированные модели для этого не нужны, хватает одного параметра. Если в кадре важны надписи, экономии нет, остаётся 25 шагов. Но 25 шагов работают как страховка, а не как норма для каждого кадра.
Источникnote #画像生成AI