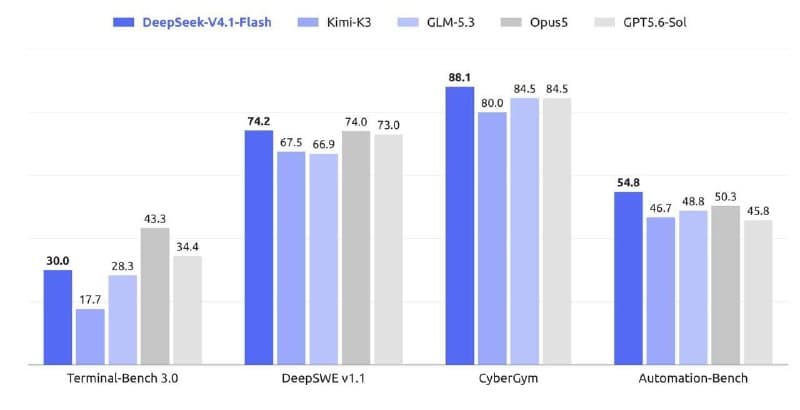
- 552 млрд параметров всего, но активно юзает только 8 млрд на ввод и 16 млрд на генерацию. Экономия ресурсов без потери мозгов
- KV Cache сокращен до 890 байт/токен — в 4 раза меньше прошлой версии. Длинные диалоги больше не жрут оперативку как не в себя
- Мультимодальность из коробки: текст + изображения в одном окне, без костылей и сторонних сервисов
- Контекст до 1 млн токенов — закидывай целые кодовые базы, книги или транскрипты подкастов
- Настраиваемая глубина рассуждений от 1 до 100 — сам решаешь, насколько модель должна «думать» над ответом
Новость
ИИ дешевле воды, но без воды
DeepSeek V4.1 Flash — модель, которая стоит в 3300 раз дешевле GPT-6 Astra и в 1600 раз дешевле Claude Opus 5