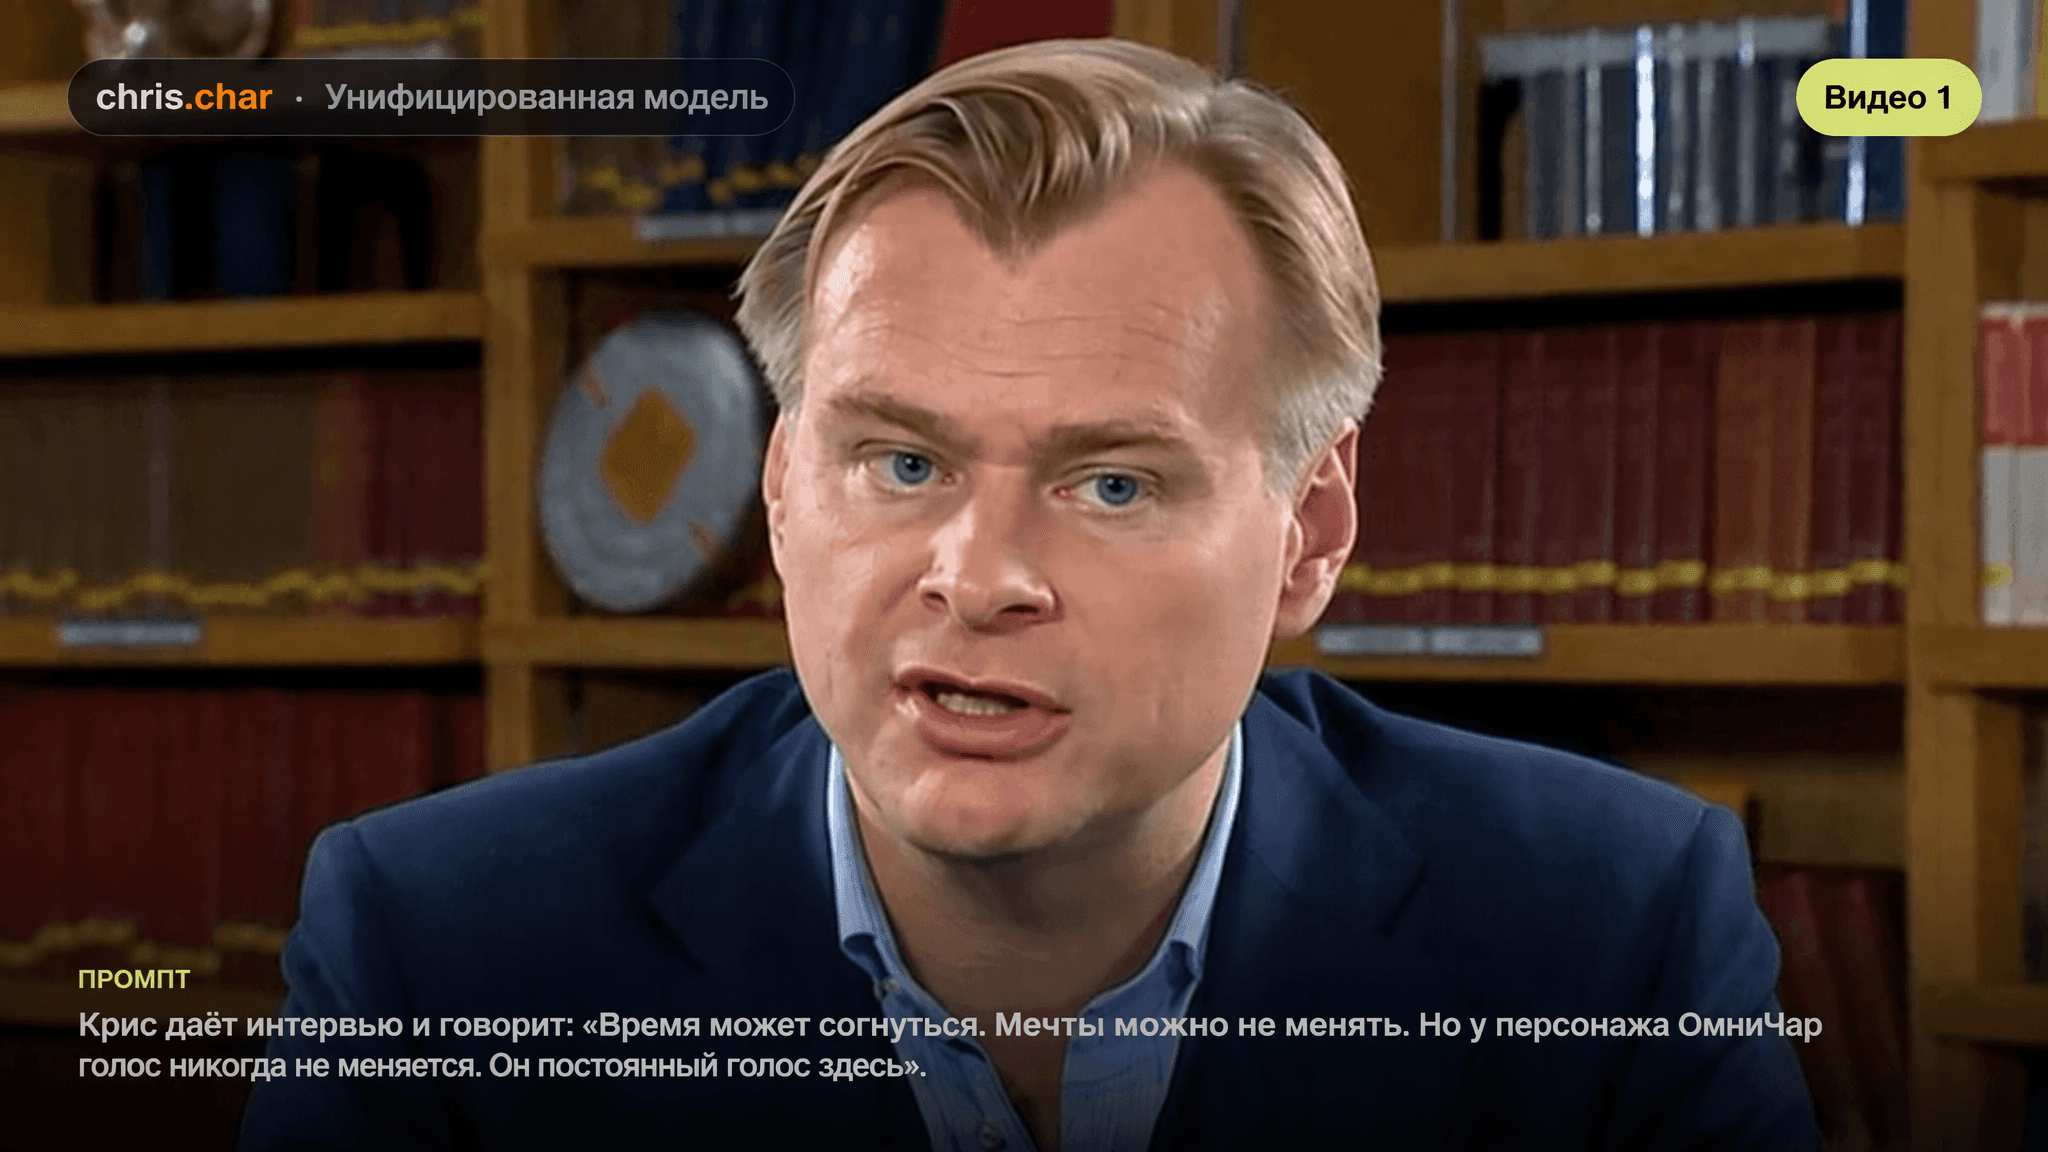
OmniChar уже собирал персонажа в переносимый формат .char с консистентными лицом, одеждой и телом. Теперь автор воркфлоу добавил к этому голос: достаточно загрузить сэмпл длиной 10–30 секунд в MP3 или WAV. Персонаж будет произносить заданные реплики клонированным голосом, сохраняя его между генерациями.
В ComfyUI-ноде появился необязательный вход для образца голоса. В примерах персонаж даёт интервью: сначала говорит о том, что голос не должен меняться, затем — что .char хранит лицо, одежду и тело. Можно задавать реплики и небольшие жесты руками; сам формат задуман как переносимый набор данных персонажа.
Липсинк обеспечивает MiniMax H3 — сверху к нему ничего не добавляют. С английским результат, по словам автора, хороший, но на других языках модель может нести чепуху. Ещё одна оговорка: в голосовом образце лучше не смешивать нескольких говорящих.
ComfyUI-нода пока выходит в nightly-версии: понадобится обновить настройки или установить её напрямую из Git-репозитория. В ноде уже лежат примеры входных данных и воркфлоу для создания .char с голосом и генерации через MiniMax H3. Напоминаю: это не гарантия идеального дубляжа на любом языке — пока лучше проверять на коротких репликах.
Главное
- Аудиосэмпл: 10–30 секунд, формат MP3 или WAV
- Один голос в образце — иначе результат может быть нестабильным
- Липсинк генерирует сам MiniMax H3, дополнительных этапов нет
- ComfyUI-нода доступна в nightly-сборке и через прямую установку из Git
ИсточникReddit: AI-видео и картинки