17 ноября Ant Group и компания Xihu Xinchen выложили в открытый доступ Duo v1: код, веса и техотчёт. Для тех, кто делает интерактивных персонажей, это важно: виртуальный собеседник реагирует на твои голос и жесты, а не ждёт команды с клавиатуры.
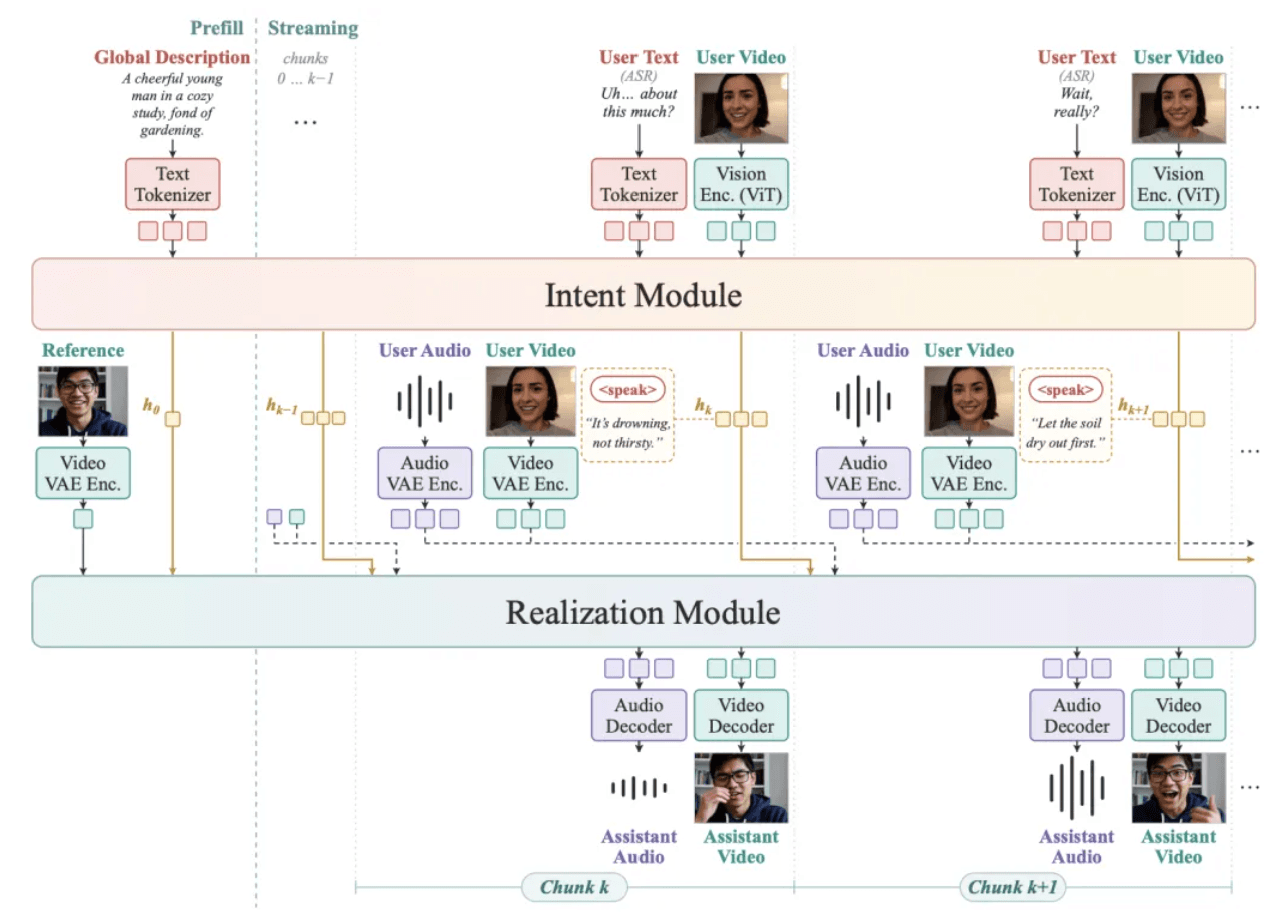
Работает это так. Каждые примерно 0,7 секунды модель решает, сказать что-то или подождать. Этим занимается модуль Intent. Второй модуль, Realization, по его решению генерирует голос и картинку. В примере из материала персонаж после пробежки говорит, что хочет пить. Ты протягиваешь ему бутылку с водой, и он её берёт и пьёт.
Команда дала и цифры. На 30 живых диалогах по 180 пунктам модель прошла 168 проверок, то есть 93,3%. Понятность речи, следование языку и стабильность внешности набрали по 100%. А вот реакция на содержание только 73,3%, и с длинными сессиями пока сложно. Оценка их собственная, и выборка маленькая, так что это заявка с цифрами, а не широкий замер.
Обучение идёт в три стадии, а потом модель дистиллируют до 4 шагов генерации. Чтобы картинка не выцветала на длинном ролике, взяли первый сегмент как эталон лица. В тесте на 60 секунд яркость у базового метода упала с 103,8 до 69,6, а с их подходом держалась около 99.
Итог такой: на долгих диалогах и точной реакции Duo v1 ещё сыроват. Зато схема, где персонаж сам решает, когда отвечать, уже работает, и её можно взять и дорабатывать.
Источник智东西