ByteDance запустила OmniHuman 2.0 15 октября: модель делает аватар-видео по изображению и аудио, до пяти минут одним непрерывным кадром. Для создателей это способ оживить персонажа без съёмки, но качество речи и движений всё ещё стоит проверять отдельно.
По сообщению BytePlus, модель работает с речью, музыкой и диалогами, учитывает тон и эмоции аудио. Это заявление компании, а не результат независимого замера. Автор материала на note сравнил OmniHuman 2.0 с HeyGen Avatar V на японской речи и движениях.
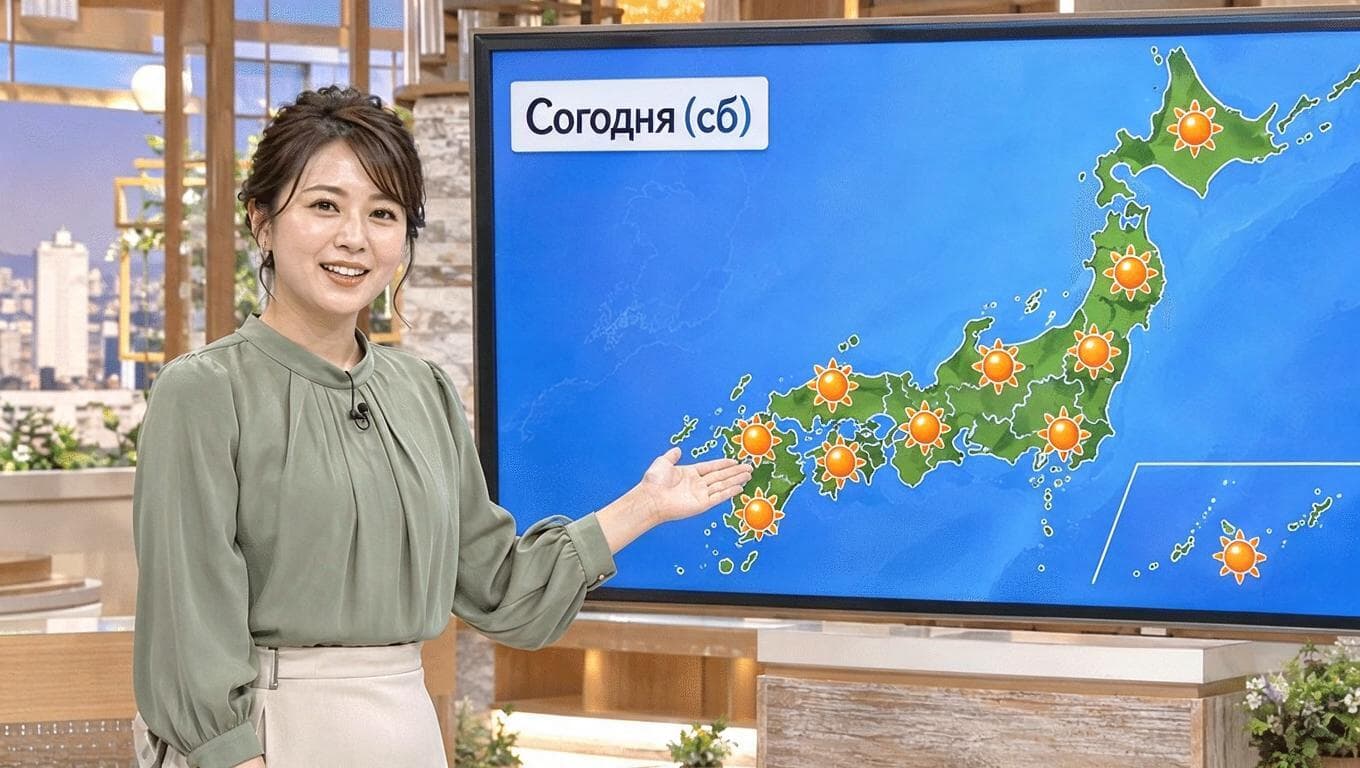
В сцене с ведущей прогноза погоды OmniHuman довольно естественно двигала телом, пока та читала текст. Автор также попросил её чихнуть и сказать «извините». А вот движения рта местами не совпадали с аудио, а взгляду не хватало естественности. То есть обычную подачу модель тянет лучше, чем конкретный жест.
У HeyGen липсинк в этом сравнении выглядел лучше, но чихнуть модель толком не смогла. Получается, одной идеальной синхронизации мало: если в ролике есть действие, его тоже придётся оценивать. OmniHuman 2.0 уже умеет делать длинный дубль, но для живой сцены пока важны и рот, и глаза, и весь остальной актёр.
Источникnote #動画生成AI